ACE-Brain-0.6 supera a GPT-6 Astra en pruebas espaciales internas
Pida a un robot que recoja una pieza, y el paso más difícil no es el movimiento del brazo, sino saber exactamente dónde está la pieza. Ese es el problema que, según ACE Robotics, resuelve su nuevo modelo, ACE-Brain-0.6. La compañía, presidida por el cofundador de SenseTime Xiaogang Wang, lo describe como un modelo fundacional corporeizado de unos 9.000 millones de parámetros, es decir, los valores numéricos que una red neuronal aprende durante el entrenamiento y una medida aproximada de su tamaño. Su foco es el anclaje visual: vincular una instrucción en lenguaje natural con una ubicación precisa, una parte de un objeto o una zona de interacción en una escena física.
El modelo se basa en Qwen3.5-9B. Su codificador de visión permanece congelado, lo que significa que la parte que lee las imágenes no se reentrena, mientras que la parte lingüística se ajustó con cerca de un millón de muestras espaciales, que abarcan unas 940.000 imágenes y 2,7 millones de pares de pregunta y respuesta. Los datos de entrenamiento combinan más de 30 conjuntos de datos abiertos de robótica con grabaciones privadas en primera persona. Herramientas como Grounding DINO y SAM 3 convierten las señales del estado de la pinza y del movimiento en etiquetas espaciales que pueden verificarse. ACE Robotics asegura que el modelo solo responde cuando la evidencia visual está completa: antes de responder una pregunta de conteo, por ejemplo, cada instancia debe estar etiquetada.
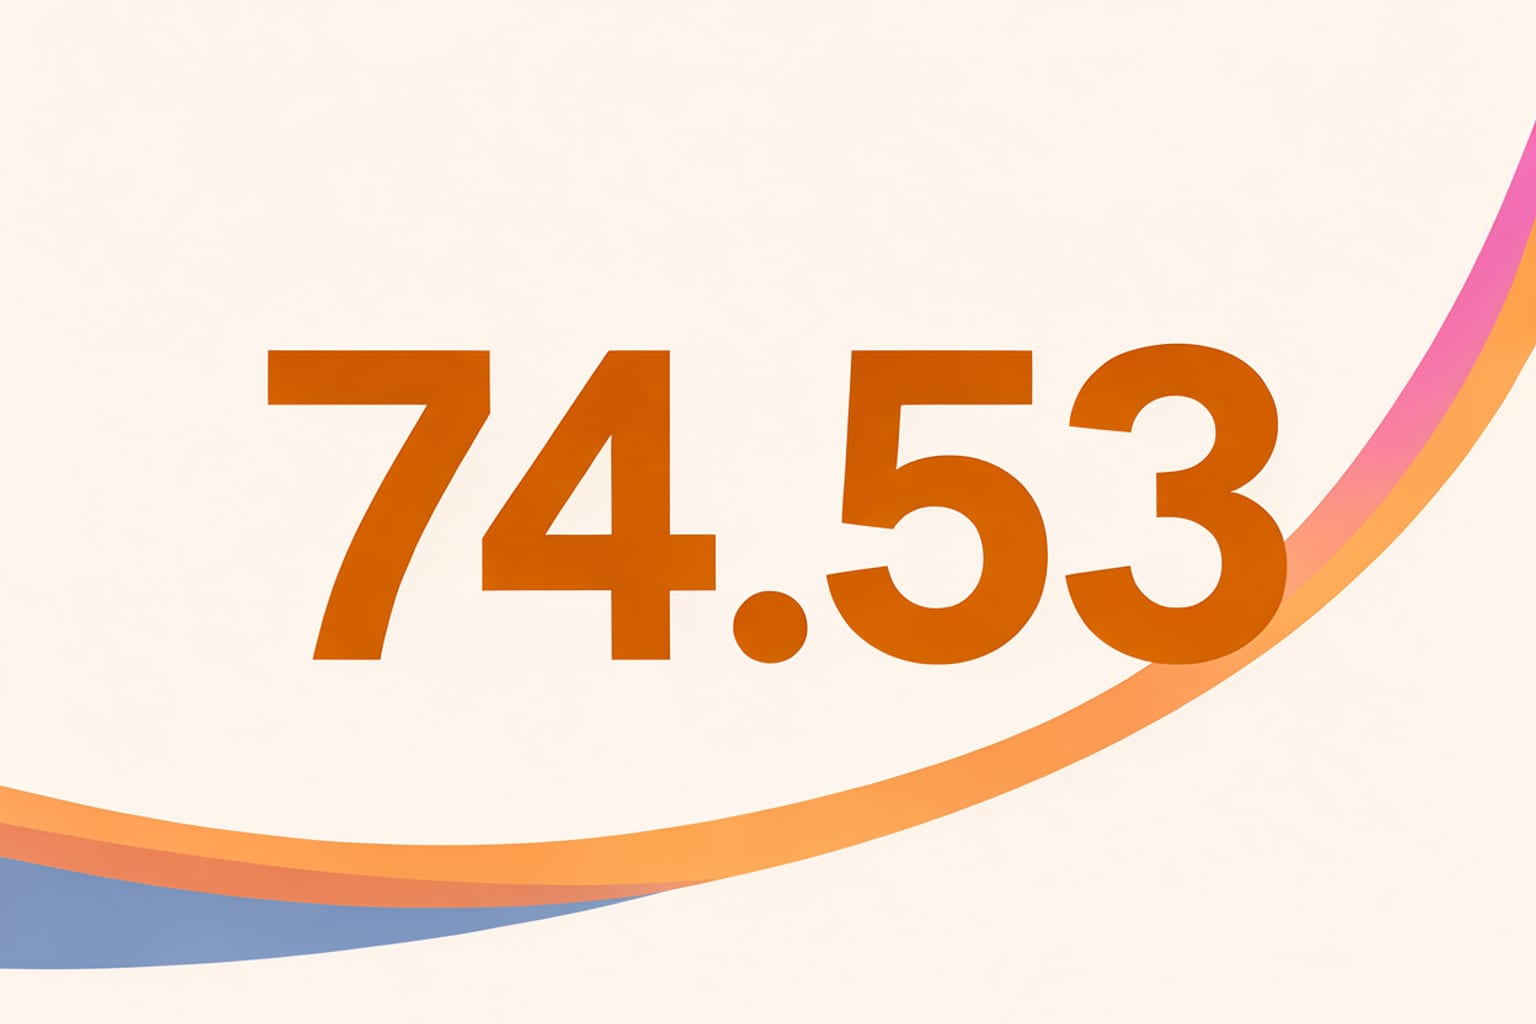
Las cifras de rendimiento son de la propia empresa y aún no han sido verificadas de forma independiente. En seis de las ocho evaluaciones de anclaje, ACE-Brain-0.6 supera a GPT-6 Astra, el modelo de OpenAI incluido en la comparación de la compañía. En Where2Place alcanza 76,55 frente a 71,10 y, en RobotGrounding, un conjunto de 2.591 preguntas que el equipo creó por sí mismo en 14 tipos de tarea, 94,13 frente a 91,10. Promediadas en siete pruebas públicas, las puntuaciones son 74,53 y 73,68. Esa ventaja es pequeña y se mide en pruebas que eligió la empresa.
El resultado más instructivo se refiere a los datos. En pruebas controladas, manteniendo fijos la arquitectura y la receta de entrenamiento, al ampliar el conjunto de entrenamiento de 260.000 a cerca de un millón de muestras, el promedio de las siete pruebas públicas pasó de 69,3 a 74,5, en una curva que la compañía describe como casi logarítmico-lineal. Duplicar los datos añadió unos 2,4 puntos de media, mientras que sumar más muestras del mismo tipo mejoró menos de un punto. Las mejoras procedieron de la variedad, es decir, de nuevas escenas, relaciones espaciales y formatos de supervisión, y no del volumen.
De momento, el beneficio práctico es limitado. En la fecha de publicación, los pesos de ACE-Brain-0.6 no figuraban como abiertos; los repositorios públicos de GitHub de DAXIAORobotics siguen listando ACE-Brain-0 y ACE-Brain-0.5. Los equipos de robótica que quieran probar el modelo en su propio hardware tendrán que esperar a una publicación que todavía no pueden descargar. Si la versión abierta llega y los resultados se sostienen fuera de las pruebas de la propia empresa, las ventajas llegarían antes a los grupos de investigación y a los fabricantes de robots, que podrían comprobar si unos datos mejor elegidos ayudan a sus robots a encontrar aquello que deben agarrar.
Comentarios
Cargando el hilo…
Inicia sesión para escribir un comentario. Iniciar sesión